



Microsoft, Maia 200 entra in produzione: i nuovi chip Maia 300 arriveranno nel 2027
Dall’anno prossimo Maia diventerà il principale sistema di inferenza dei prodotti Microsoft, con installazioni su scala di più gigawatt. L’obiettivo è servire più richieste con la stessa energia e controllare una parte maggiore dei costi di Copilot e degli agenti.

4' di lettura
4' di lettura
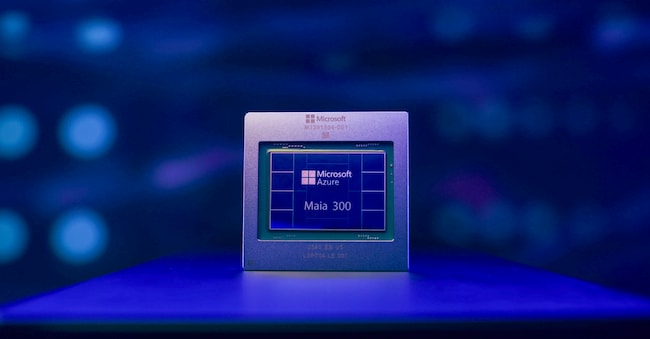
Microsoft ha annunciato che dal 2027 estenderà le installazioni della propria famiglia di chip Azure Maia su scala di più gigawatt, facendone il principale sistema di inferenza dei suoi prodotti e servizi. L’obiettivo è ridurre il costo delle operazioni che Copilot esegue ogni volta che riassume una riunione, suggerisce una riga di codice o legge un documento. Per rispondere bisogna eseguire il modello, spostare i dati e alimentare le memorie: su milioni di richieste, l’efficienza di queste operazioni incide sui conti dell’intelligenza artificiale.
Chiedilo al Sole
Cosa è Maia e a cosa serve l’inferenza?
Mettiamola così: ogni volta che Copilot riassume una riunione, suggerisce una riga di codice o legge un documento, Microsoft sostiene un costo. Bisogna eseguire il modello, spostare i dati, alimentare le memorie. Su milioni di richieste, queste operazioni diventano una questione industriale. L’inferenza è il lavoro che un modello già addestrato compie per rispondere a una richiesta. Durante l’addestramento acquisisce le capacità che poi utilizza nelle interazioni con gli utenti. Con gli agenti il conto può aumentare: per svolgere un incarico, un sistema può interrogare più volte il modello, usare strumenti esterni, esaminare i risultati e correggere il percorso. Una sola richiesta può quindi richiedere numerosi passaggi di elaborazione. Sostanzialmente il nuovo piano Azure Maia interviene su questa voce della fattura dell’intelligenza artificiale. Secondo Microsoft, esegue carichi di produzione di Microsoft 365 Copilot e sostiene il gruppo Microsoft AI nello sviluppo dei modelli. GitHub Copilot e Microsoft Foundry seguiranno entro fine anno. Sull’hardware girano modelli OpenAI, modelli interni MAI e famiglie open source. Il programma ha superato la fase dimostrativa ed è entrato nei servizi dai quali l’azienda deve ottenere ricavi e margini. Ecco perché è cos’ì importante per i conti di Microsoft e per il mercato dell’AI.
Loading...
Come è fatto Maia 300?
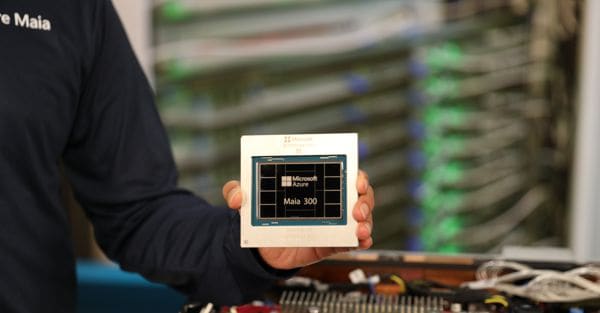
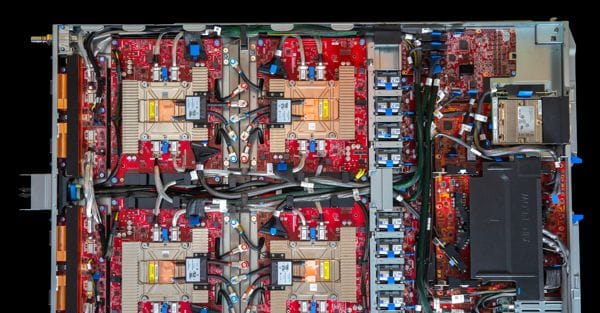
Microsoft lo presenta come un sistema completo, sviluppato insieme al software, alle memorie e alle reti. La ragione è concreta: nell’inferenza, soprattutto durante la generazione delle risposte e quando il modello deve gestire contesti lunghi, le unità di calcolo possono restare in attesa dei dati. Poter eseguire più operazioni serve poco se le informazioni arrivano troppo lentamente.
Maia 300 punta a ridurre queste attese. Il software stabilisce dove collocare i dati e come trasferirli tra memorie, unità di calcolo e acceleratori. Una memoria locale sul chip mantiene le informazioni vicine alle unità che le utilizzano, riducendo il traffico verso la memoria principale. In questo modo una quota maggiore dell’energia può essere destinata all’elaborazione.
Le specifiche dichiarate indicano le dimensioni del progetto: otto stack di memoria HBM4, con una banda di picco complessiva di 18 terabyte al secondo e un TDP di 950 watt per acceleratore. Calcolo, controllo della memoria e connessioni sono distribuiti su diversi chiplet, piccoli componenti integrati nello stesso package. Quelli dedicati al calcolo saranno realizzati con il processo N2P di TSMC.


Brand connect
Loading...
